


Dans l’industrie technologique, il est difficile d’avoir une conversation sans que quelqu’un mentionne l’inférence, l’intelligence artificielle (IA) et l’apprentissage automatique (ML). Cependant, il est important de noter que même si tous ces termes sont interconnectés, ils diffèrent également considérablement.
Dans cet article, nous expliquerons les différences fondamentales et soulignerons l'importance d'utiliser la technologie d'IA de pointe basée sur le traitement tensoriel-, en particulier dans les systèmes de pointe et intégrés. Par rapport aux solutions basées sur des unités de traitement graphique (GPU), les unités de traitement tensoriel (TPU) offrent des performances plus efficaces et-plus rentables. Nous fournirons également quelques exemples de cas d'utilisation illustrant les domaines dans lesquels vous pourriez rencontrer des solutions d'IA de pointe à l'avenir.
Fondamentaux du ML et de l'inférence
ML fait référence à la méthodologie de formation de modèles utilisant des données représentatives pour permettre aux machines d'apprendre à effectuer des tâches. Ce processus peut être très gourmand en calcul, générant des milliards d’opérations par nouveau point de données de formation. La nature itérative du processus d'entraînement, combinée aux énormes ensembles de données d'entraînement requis pour atteindre une précision élevée, entraîne la demande d'un traitement à virgule flottante -performances-extrêmement élevées. La formation ML est mieux mise en œuvre en tant qu'infrastructure de centre de données, où les coûts d'investissement et opérationnels élevés peuvent être justifiés en les amortissant sur de nombreux clients.
L'inférence implique l'utilisation de modèles entraînés pour générer des correspondances potentielles pour de nouvelles données pertinentes par rapport aux données représentatives sur lesquelles le modèle a été formé. L'inférence vise à fournir des réponses rapides en quelques millisecondes. Des exemples d'inférence incluent la reconnaissance vocale, la traduction linguistique en temps réel, la vision industrielle et les décisions d'optimisation de l'insertion publicitaire. Même si l'inférence ne nécessite qu'une fraction de la puissance de traitement nécessaire à la formation, elle dépasse encore de loin ce que les systèmes traditionnels basés sur une unité centrale (CPU)-peuvent fournir, en particulier pour les applications de vision par ordinateur. C'est pourquoi tant d'entreprises se tournent vers des -solutions d'accélération basées sur le tenseur-que ce soit sous forme d'IP sur les SoC ou dans les -accélérateurs système-pour atteindre les temps de réponse inférieurs à-secondes requis à la périphérie. La réalité est que passer ne serait-ce qu’une minute ou quelques secondes à traiter des images dans un système de vision n’est pas très utile. Les systèmes de vision industrielle recherchent des vitesses de traitement de l'ordre de la milliseconde-.
Séparer la formation et l'inférence
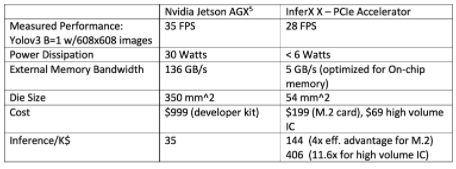
Le déploiement du même matériel que celui utilisé pour l'entraînement afin de gérer les charges de travail d'inférence peut entraîner un sur-approvisionnement des machines d'inférence en accélérateurs et en matériel CPU. Les solutions GPU développées pour le ML au cours de la dernière décennie ne constituent pas nécessairement le choix optimal pour le déploiement à grande échelle des technologies d'inférence ML. Le schéma ci-dessous illustre parfaitement la comparaison entre les accélérateurs TPU et les accélérateurs GPU. Il montre clairement que les accélérateurs TPU offrent une consommation d'énergie inférieure, des coûts réduits et une efficacité supérieure par rapport aux solutions AGX basées sur GPU-, tout en offrant des niveaux de performances convaincants pour les applications d'inférence.
Une autre considération essentielle lors de l’approche des solutions de formation et d’inférence ML est l’environnement logiciel. Aujourd'hui, de nombreuses bibliothèques populaires sont utilisées, telles que CUDA pour les GPU NVIDIA, des frameworks ML comme TensorFlow et PyTorch, des bibliothèques de modèles multiplateformes optimisées-comme Keras, et bien plus encore. Ces boîtes à outils sont essentielles au développement et à la formation de modèles ML, mais les applications d'inférence nécessitent un ensemble d'outils logiciels différent et plus restreint.
Les boîtes à outils d'inférence se concentrent sur l'exécution de modèles sur les plates-formes cibles. Ils prennent en charge le portage de modèles formés sur des plates-formes, ce qui peut impliquer certaines transformations d'opérateur, des services de quantification et d'intégration d'hôtes. Cependant, cela représente un ensemble de fonctionnalités relativement simples par rapport à celles requises pour le développement et la formation de modèles.
Les outils d'inférence bénéficient du fait de commencer par une représentation standardisée du modèle. L'Open Neural Network Exchange (ONNX) est le format standard pour représenter les modèles ML. Comme son nom l'indique, il s'agit d'un standard ouvert géré comme un projet de la Linux Foundation. Des technologies comme ONNX permettent le découplage des systèmes de formation et d'inférence, offrant ainsi aux développeurs la liberté de choisir différentes plates-formes optimisées pour chacun.
Exemples d'applications visuelles
À mesure que les technologies de ML et de processeur d’inférence continuent de progresser et d’évoluer, les applications prolifèrent. Vous trouverez ci-dessous quelques endroits où vous pourriez rencontrer cette technologie à l’avenir.
Serveurs Edge dans des entreprises telles que des usines, des hôpitaux, des magasins de détail et des institutions financières. Par exemple, dans les environnements industriels, l’IA peut faciliter la gestion des stocks, la détection des défauts et même la maintenance prédictive avant que des problèmes ne surviennent. Dans le commerce de détail, il permet des fonctionnalités telles que l'estimation de la pose, en utilisant la vision par ordinateur pour détecter et analyser la posture humaine. Les données de cette analyse aident les détaillants physiques-et-à mieux comprendre le comportement humain et le trafic piétonnier dans leurs magasins, leur permettant ainsi d'optimiser l'agencement des magasins pour optimiser les ventes et la satisfaction des clients.
Imagerie de haute-précision/haute-qualité pour des applications telles que la robotique, l'automatisation/l'inspection industrielle, l'imagerie médicale, l'imagerie scientifique, les caméras de surveillance et de reconnaissance d'objets, ainsi que la photonique. Par exemple, les méthodes d'apprentissage automatique ont démontré la capacité de détecter le cancer en traitant les rayons X numériques-. Ce processus implique le développement d'un modèle ML conçu pour traiter les images à rayons X-, généralement à l'aide d'algorithmes de segmentation sémantique entraînés pour identifier les lésions cancéreuses. Au cours de la formation, les images de cancer identifiées par les radiologues sont utilisées pour enseigner au réseau ce qui n'est pas un cancer, ce qu'est un cancer et comment apparaissent les différents types de cancer. Plus un modèle ML est entraîné, plus il parvient à maximiser les diagnostics corrects et à minimiser les erreurs de diagnostic. Cela signifie que l’apprentissage automatique repose non seulement sur la conception de modèles intelligents, mais également sur de grandes quantités (des dizaines de milliers, voire des millions) d’exemples de données soigneusement sélectionnés dans lesquels le cancer a été identifié de manière experte.
Paniers d'achat intelligents-Plusieurs entreprises développent et déploient des systèmes d'achat intelligents qui reconnaissent les produits non pas par leurs codes-barres UPC, mais par l'apparence visuelle de l'emballage lui-même. Cette fonctionnalité permet aux acheteurs de simplement placer des articles dans le panier ou sur le système de paiement sans avoir besoin de localiser le code UPC et de le scanner avec un scanner laser UPC. Cette technologie rend le processus d’achat plus précis, plus rapide et plus pratique.
Prendre la bonne décision
Les entreprises doivent évaluer toutes les solutions disponibles aujourd'hui et sélectionner la solution optimale en fonction de leur cas d'utilisation spécifique. Ils ne peuvent pas non plus simplement supposer que toutes les solutions d'IA sont mieux mises en œuvre sur les appareils GPU, car les solutions basées sur TPU-offrent une efficacité de traitement plus élevée et une utilisation moindre du silicium, réduisant ainsi la consommation d'énergie et les coûts.